特許事務所で生成AIを使うとき、最初に決めるべきなのは「使うか、使わないか」ではありません。
決める必要があるのは、どの契約・設定の生成AI環境に、どの段階の情報まで入れるのかです。
公開済みの特許公報を整理する作業と、まだ出願していない発明内容を生成AIへ入力する作業では、情報の性質が大きく異なります。また、同じ生成AIサービスであっても、個人向けの利用環境と事務所が契約・管理する法人向け環境、APIを利用する環境では、データの取り扱い条件が同じとは限りません。
そのため、「ChatGPTを使ってよいか」といったサービス名だけのルールでは、実務上の判断ができません。
日本弁理士会の「弁理士業務 AI 利活用ガイドライン」でも、生成AIの出力は正確性が保証されたものではなく、弁理士が内容を確認し、最終的には弁理士が責任を持って提供すべきとされています。また、弁理士は機密情報や非公開情報を取り扱うため、生成AI利用には注意が必要とされています。
少人数の特許事務所では、所長が「未公開情報は入れない」と考えていても、事務職員や他の弁理士が個人契約の生成AIを日常業務で使っていることがあります。全面禁止にすれば管理は単純になりますが、公開資料の整理、複数文書の比較、文章の下書き、転記前のデータ整理など、生成AIが得意な作業まで止めることになります。
必要なのは、禁止か自由利用かの二択ではありません。
判断と責任は有資格者が担い、下書き・突合・転記などの作業を生成AIに任せる。そのうえで、生成AIへ渡す情報と利用する環境の境界を明文化することが重要です。
この記事では、未公開の発明を扱う特許事務所を中心に、少人数の士業事務所が生成AIを業務へ組み込むときの線引きを、実際の仕事の流れに沿って整理します。
特許事務所で未公開発明を生成AIに入れる前に確認する3つの論点
特許事務所が生成AIを業務で使う際は、単に「情報漏洩しないAIを選べばよい」と考えないことが重要です。
少なくとも、守秘義務と秘密情報の取り扱い、出願前の発明と新規性、クライアントとの契約という3つの論点を分けて確認する必要があります。
それぞれ別の問題であるため、一つの条件を満たしたからといって、すべての情報を入力できるとは限りません。
守秘義務と秘密情報の取り扱いを確認する
特許事務所には、依頼者からまだ公開されていない技術内容、発明者に関する情報、研究開発の方向性、競合他社との関係、出願戦略など、多くの非公開情報が集まります。
日本弁理士会のガイドラインでは、弁理士は弁理士法第30条の守秘義務を負っており、外部事業者が提供する生成AIへ秘密情報を入力する行為について、生成AI提供者という第三者への秘密情報の開示となるため、守秘義務に違反するおそれがあると整理されています。また、秘密保持契約を締結している場合には、契約上の義務との関係も問題になり得るとされています。
したがって、「AIの精度が高いから使う」「有料プランだから使う」といった判断だけでは不十分です。
生成AIへ情報を送信したとき、その情報がどのように処理されるのか、モデル学習に利用されるのか、保存されるのか、保存される場合はどの程度の期間なのか、誰がアクセスし得るのか、事務所として契約条件を把握できるのか、といった点まで確認する必要があります。
特に注意したいのは、「学習されない」という説明だけを見て安全と判断しないことです。
学習利用とデータ保存は同じ意味ではありません。モデル改善には使われなくても、サービス提供や不正利用監視などのため一定期間データが保存される仕組みもあります。
出願前の発明と新規性の関係を確認する
特許事務所では、一般企業の生成AI利用とは異なる固有の論点があります。それが、出願前の発明を扱うことです。
日本弁理士会のガイドラインでは、知財分野では新規性喪失の観点からも注意が必要であり、秘密保持規約のない第三者のプラットフォームへ情報を載せた場合には、新規性を喪失する可能性があると示されています。そのため、生成AIを利用するときには、秘密保持規約等のあるプラットフォームかどうかを確認する必要があるとされています。
ただし、ここで「生成AIへ入力すれば新規性を失う」「法人向けAIなら必ず新規性を失わない」と一律に判断することは適切ではありません。
どのような入力行為が特定の案件でどのような法的評価を受けるかは、利用環境、契約内容、情報の公開状態、具体的な事情などによって異なります。
だからこそ、所内ルールでは法的結論を所員に判断させるのではなく、出願前の技術情報については、承認された環境と承認された用途以外では入力しないという運用上の線を先に引くことが有効です。
「問題が起きたら法的にどう評価されるか」を考えるよりも、「そもそも判断が必要な入力を無秩序に発生させない」ことが重要です。
クライアントとの契約・個別指示を確認する
生成AI提供会社との契約条件だけを確認しても十分ではありません。
クライアントとの委任契約、秘密保持契約、セキュリティ基準、外部サービス利用に関する条件なども確認する必要があります。
たとえば、技術的には一定のセキュリティ条件を備えた環境であっても、依頼者との契約上、生成AIへの入力や外部クラウドサービスへの情報保存が制限されている可能性があります。
反対に、クライアントから生成AI利用について特段の禁止がなくても、それだけで自由に入力してよいという意味にはなりません。
少人数の事務所ほど、「いつものクライアントだから」「長い付き合いだから」と運用が口頭になりやすい傾向があります。しかし、生成AIを継続的に利用するのであれば、案件ごとの条件と事務所共通ルールを切り分けておいた方が安全です。
所内ルールでは、事務所として通常利用できる範囲を決めたうえで、クライアントごとに追加制限がある場合は、そちらを優先する仕組みにしておくと運用しやすくなります。
まず「生成AIの環境」と「情報の段階」を二軸で分ける
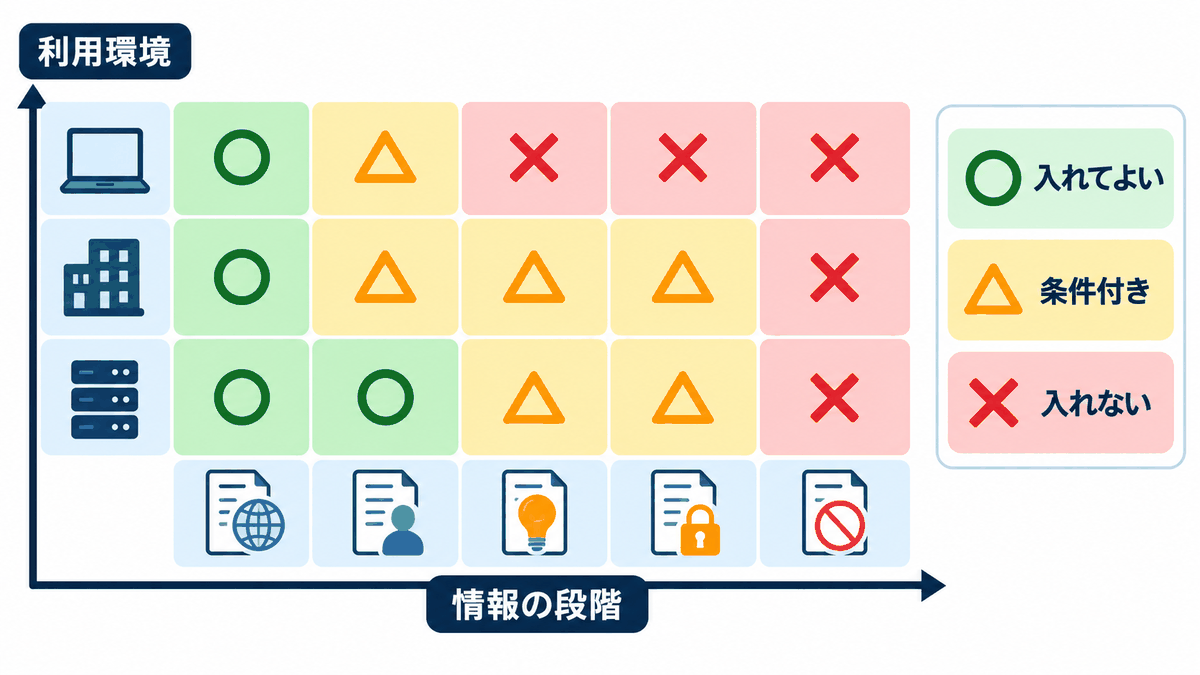
特許事務所の生成AI利用を整理するときに、最も避けたいのが「このAIは使ってよい」「このAIは禁止」というサービス名だけの分類です。
同じサービスでも、契約形態や設定によってデータの取り扱いが異なる場合があります。また、安全性の高い環境を用意したとしても、クライアントが生成AI利用を禁止している案件まで入力してよいことにはなりません。
そこで、所内ルールを作るときは、利用環境と入力情報の二軸で考えます。
軸1は「どの生成AI環境を使うのか」
最初に確認するのは、誰がどの契約で生成AIを利用しているのかです。
1〜5人規模の事務所では、所長が法人向けサービスを契約している一方、職員が以前から持っている個人アカウントを併用していることがあります。
この状態では、「事務所では生成AIを導入済み」という認識と、実際に情報が送信されている環境が一致しません。
環境を確認するときは、単なるプラン名ではなく、次のような項目を表にして管理すると分かりやすくなります。
| 確認項目 | 確認する内容 |
|---|---|
| 契約主体 | 個人契約か、事務所・法人契約か |
| モデル学習への利用 | 入力・出力がモデル改善等に利用される条件 |
| データ保持 | 入力・出力やログが保存されるか、保存期間はどうなっているか |
| 管理権限 | 所長・管理者が利用者や設定を管理できるか |
| アカウント | 職員個人のアカウントか、事務所が発行・管理するアカウントか |
| 外部連携 | ファイル保存先、外部アプリ、コネクタ等へ情報が渡るか |
| 契約条件 | 秘密情報や業務情報の取り扱いに関する規約がどうなっているか |
| 利用記録 | 誰がどの環境を利用したか確認できるか |
たとえばOpenAIは、ChatGPT Business、ChatGPT Enterprise、APIなどのビジネス向けサービスでは、デフォルトで入力・出力をモデルの学習や改善に利用しないと説明しています。
一方、個人用ワークスペースのChatGPT Free、Plus、Proについては、データ共有がデフォルトで有効になっており、設定からモデル学習への利用をオプトアウトできるとされています。
ここから分かるのは、「有料か無料か」だけでは判断できないということです。
さらにAPIについても、入力・出力を学習に使用しないことと、データが一切保持されないことは同義ではありません。OpenAIのAPIドキュメントでは、不正利用監視用のログが原則として最大30日保持される場合があり、機能によってアプリケーション状態の保存条件も異なると説明されています。一定の要件を満たす利用者向けにはゼロデータ保持の仕組みもあります。
したがって、所内ルールには「学習されないAIを使う」とだけ書くのではなく、どの契約・どのワークスペース・どの設定を承認環境とするのかまで記載する必要があります。
軸2は「どの段階の情報を渡すのか」
次に、AIへ渡す情報を段階で分けます。
すべての情報を「機密情報」と一括りにすると、実務では判断できません。
特許事務所であれば、すでに公開された公報と、まだ出願していない発明の技術内容では、扱いが異なります。また、同じ未公開情報でも、依頼者名や発明者名を除いて抽象化した情報と、案件一式をそのまま入力する場合では情報量が違います。
所内では、少なくとも次のような区分を持つと判断しやすくなります。
| 情報の段階 | 典型的な内容 | 所内での考え方 |
|---|---|---|
| 公開済み情報 | 公開公報、公開済みWeb情報、公開された審査情報など | 承認環境で利用しやすい |
| 匿名化・抽象化した情報 | 依頼者名や案件識別情報を除いた文章、一般化した技術説明 | 元情報を復元できないか確認して利用 |
| 出願前の発明情報 | まだ公開されていない技術内容、発明者からのヒアリング内容 | 承認環境・案件条件・契約条件を確認 |
| 未公開の出願関係情報 | 未公開段階の明細書、図面、社内検討資料など | 承認環境・案件条件・契約条件を確認 |
| AI利用を制限された案件 | クライアントが外部AI利用等を禁止・制限している案件 | 制限内容に従う |
重要なのは、「匿名化すれば必ず大丈夫」と考えないことです。
会社名をA社に置き換えただけでも、技術内容、製品名、担当者情報、日付、競合関係などの組み合わせから案件を推測できることがあります。
匿名化は、名前を消す作業ではなく、その情報が案件や依頼者へ結び付く可能性を下げる作業として考える必要があります。
「学習されない」という一条件だけで決めない
生成AIに関する社内説明では、「このプランは学習に使われないから安全です」という表現が使われがちです。
しかし、特許事務所の所内ルールとしては、それだけでは足りません。
学習利用、保存期間、アクセス権限、外部連携、アカウント管理、クライアントとの契約条件は、それぞれ別の確認項目です。
たとえばモデル学習に利用されない環境でも、チャット履歴が保存されることがあります。APIであれば、サービス提供や不正利用監視などのためログが一定期間保持される仕組みが存在する場合があります。外部サービスと接続していれば、生成AI提供会社だけではなく接続先のデータ取り扱い条件も確認対象になります。
つまり、所内の判断基準は次のようになります。
「学習されるか」ではなく、「この情報を、この環境へ、この目的で送ってよいか」です。
この文章を所員全員が理解できる状態にしておくことが、ルール運用の第一歩になります。
特許事務所では「環境×情報の段階」で入力可否を判断する
利用環境と情報段階を分けたら、次は両方を掛け合わせます。
所員に「慎重に判断してください」と伝えても、忙しい実務の中では判断できません。案件を開くたびに利用規約を読み直す運用も現実的ではありません。
そこで、事務所で承認した判断表を用意します。
以下は考え方を整理するためのひな形です。個別案件に対する法的判断ではなく、実際のルールを作る際は、利用サービスの最新規約やクライアントとの契約条件を確認してください。
| 情報の種類 | 個人管理のAI環境 | 事務所管理の承認環境 | データ条件を個別確認した環境 |
|---|---|---|---|
| 公開済み公報・公開資料 | 所内ルールに従い利用範囲を限定 | 利用を検討しやすい | 利用を検討しやすい |
| 十分に匿名化・抽象化した情報 | 復元可能性を確認 | 条件を確認して利用 | 条件を確認して利用 |
| 出願前の発明 | 安易に入力しない | 案件条件・契約条件を確認 | 案件条件・契約条件を確認 |
| 未公開の出願資料 | 安易に入力しない | 案件条件・契約条件を確認 | 案件条件・契約条件を確認 |
| AI利用を禁止された案件 | 入力しない | 入力しない | 入力しない |
この表で大切なのは、法人向け環境の列をすべて「入力可能」にしないことです。
法人向けサービスであることは、重要な判断材料の一つです。しかし、「法人向けだから未公開発明を自由に入力できる」という結論には直結しません。
依頼者との契約、AI提供会社との契約、サービスのデータ処理条件、入力目的、事務所の内部規程などを組み合わせて判断します。
反対に、公開公報のようにすでに公開されている情報まで一律に禁止すれば、生成AIで効率化できる範囲を不必要に狭めることになります。
だからこそ、情報を段階で分ける必要があります。
手順1:AIを使うトリガーを業務ごとに決める
生成AIを安全に運用するには、「必要になったら各自が自由にAIを使う」という状態から抜け出す必要があります。
おすすめしたい考え方は、AIを使うトリガーを業務単位で決めることです。
トリガーとは、「この状態になったらAIを使う」と決める開始条件です。
たとえば公開公報を複数件確認して比較表を作る場面、既存文書と修正文書の差分を洗い出す場面、公開情報をもとに社内確認用の下書きを作る場面、複数の資料から定型項目を抜き出して案件管理へ反映する前段階などが考えられます。
一方、「案件について分からないことがあれば、とりあえずAIへ質問する」というトリガーは避けた方がよいでしょう。
この方法では、所員が質問を作る過程で未公開情報をそのまま入力する可能性があるためです。
業務をAI化するときは、次の5項目を横に並べると整理しやすくなります。
| 業務 | トリガー | AIに渡すもの | 反映先 | 人が確認する箇所 |
|---|---|---|---|---|
| 公開公報の整理 | 調査対象公報がそろった | 公開済み資料 | 調査用の整理表 | 引用元との一致 |
| 文書の差分確認 | 修正版が届いた | 比較対象文書 | 差分確認表 | 重要差分の意味 |
| 下書き作成 | 材料となる公開情報がそろった | 必要部分のみ | 確認待ち文書 | 内容・表現・法的判断部分 |
| 転記前整理 | 複数資料から情報をまとめる | 必要な項目 | 確認待ちデータ | 原資料との一致 |
このように業務を定義すると、「生成AIを導入する」という抽象的な話が、「どの仕事の、どの工程に使うか」という具体的な運用へ変わります。
手順2:AIに渡す前に、人が情報を整える
生成AIを導入すると、人の仕事がすべて自動的に減るわけではありません。
むしろ最初に重要になるのは、AIが仕事をしやすいように人が情報を整える工程です。
少人数の士業事務所では、ここが最初の詰まりやすい場所です。
たとえば発明者から届いたメール、打ち合わせメモ、PDF、図面、過去案件の文書が一つのフォルダに入っていたとして、それをそのまま生成AIへ渡すのは適切ではありません。
AIが必要とするのが公開公報との比較だけなら、依頼者名、連絡先、社内事情、価格情報、未公開の研究方針まで渡す必要はありません。
まず、人が「今回のAI作業に本当に必要な情報は何か」を決めます。
そのうえで、不要な依頼者情報を削り、必要であれば案件名を置き換え、公開情報と非公開情報を切り分けます。複数資料を渡す場合も、AIに見せる必要がないページを除外することで、入力情報を減らせます。
これは単なるセキュリティ対策ではありません。
AIの精度を上げるためにも有効です。
関係のない情報を大量に渡すほど、AIは何を中心に整理すべきか判断しにくくなります。逆に、「この2文書の請求項の差分だけを抽出する」「この公開公報3件について目的、構成、効果を同じ形式で整理する」のように対象と作業を限定すると、確認もしやすくなります。
AI導入の最初の仕事は、プロンプトを書くことではありません。
業務を分解して、AIへ渡す部分と渡さない部分を決めることです。
手順3:AIには下書き・突合・転記を任せる
特許事務所で生成AIを使うときは、「AIに判断してもらう」という発想から始めない方が運用しやすくなります。
先にAIへ任せやすいのは、下書き、突合、転記前整理のように、人が確認できる作業です。
最終判断をAIへ移すのではなく、人が判断するための材料をAIに整えさせると考えます。
複数文書の差分をAIに洗い出させる
士業の仕事では、一つの文書だけを読んでも正しいか分からない作業が多くあります。
元資料と修正版、依頼者から届いた資料と作成途中の文書、以前の版と最新の版などを横に並べ、違いを確認する仕事です。
こうした作業では、AIに「どちらが法的に正しいか」を決めさせるのではなく、「何が違うか」を洗い出させます。
たとえば、旧版と新版を渡して変更箇所を項目ごとに整理させれば、人はすべての文章を最初から読み直すのではなく、AIが抽出した差分を原文で確認することに集中できます。
ただし、AIが「差分なし」と出力したからといって、実際に差分がないと確定するわけではありません。
数値、否定表現、参照番号、請求項番号、専門用語、図面との対応など、案件上重要な部分は元資料と照合します。
AIの役割は「確認不要にすること」ではなく、確認すべき箇所を絞ることです。
公開情報から確認用の下書きを作る
生成AIは、ゼロから結論を出させるより、材料を限定して下書きを作らせる方が管理しやすくなります。
たとえば公開済みの公報や公開資料を入力し、所内で確認するための要点整理を作らせる方法です。
ここでも、AIに「この発明は特許になる」「進歩性がある」といった最終的な法的評価を任せるのではありません。
公開文書に何が記載されているかを整理し、引用箇所を示し、比較用の表へ並べるところまでをAIに担当させます。
その結果を材料にして、有資格者が判断します。
この分担にしておけば、AIの出力に誤りがあった場合でも、どこを確認すればよいかが分かります。
日本弁理士会のガイドラインも、生成AIの出力は正確性が保証されておらず、最終的には弁理士が確認し責任を持って提供すべきとしています。
複数システムへ転記する前の情報整理に使う
少人数の士業事務所では、AI以前に「転記」に多くの時間が使われています。
メールを見ながら案件管理へ入力し、PDFを見ながら別の管理表へ入力し、さらに別システムへ同じ情報を登録する、といった仕事です。
生成AIは、この前処理にも使えます。
たとえば、決まった項目へ情報を整理させ、「案件名」「担当者」「確認期限」「必要資料」のような所定の形式へ変換します。
人は整理後のデータと原資料を見比べてから、案件管理システム等へ反映します。
ここで重要なのは、いきなり完全自動化を目指さないことです。
最初は「AIが整理する→人が確認する→人が反映する」という流れでも、読み取りと入力の手間は減らせます。
精度と運用が安定した業務だけ、後から自動連携を検討すればよいのです。
手順4:AIの結果をどこへ反映するか先に決める
生成AIの導入が進まない事務所では、AIから良い回答が返ってきても、その結果がチャット画面の中に残ったままになることがあります。
これでは、AIを使った本人だけが便利になり、事務所全体の業務改善にはつながりません。
AIを業務へ組み込むときは、出力の反映先まで先に決めることが大切です。
公開公報の整理結果なら調査用の確認表へ入れる。文書差分なら差分確認表へ反映する。転記前整理なら案件管理へ入力するための確認待ちデータへ入れる、といった形です。
ここで有効なのが「確認待ち」という中間状態です。
AIが生成した内容を、そのまま正式文書や確定データへ書き込ませないようにします。
たとえば次のように分けます。
| 状態 | 内容 | 扱い |
|---|---|---|
| AI生成中 | AIが下書き・抽出・整理した段階 | 確定情報として扱わない |
| 確認待ち | 人が確認するために所定の場所へ反映した段階 | 元資料と照合する |
| 確認済み | 担当者・有資格者が必要な確認を終えた段階 | 正式な業務データとして扱う |
| 確定・提出 | クライアントや提出先へ使用する段階 | 所定の承認を経る |
この仕組みがあれば、AIが直接正式データを書き換えることを防ぎながら、AIのスピードを活用できます。
特に少人数事務所では、複雑な承認システムを導入しなくても、「確認待ち」「確認済み」という状態を案件管理上で分けるだけで運用が安定します。
職種が違っても共通する3つの詰まりどころと、自分の事務所で最初の1業務を見つける方法は士業事務所のAIは何から始めるかで整理しています。あわせて拒絶理由通知への対応を下書きから始める手順も参考にしてください。
有資格者が確認する箇所と依頼者情報を入れる前の線引き
生成AIは、下書き、差分抽出、情報整理、転記前の整形までを担当させ、有資格者は発明内容の理解、法的判断を伴う部分、クライアントへ提示する内容、出願・提出前の最終内容を確認します。依頼者名、発明者情報、未公開の技術内容、未公開資料、契約上秘密とされる情報をAIへ入れる前には、承認された利用環境か、案件上の制限がないかを確認します。「迷ったら入力してから確認」ではなく、「迷った情報は入力前に確認する」を所内共通ルールにします。
手順5:所内ルールを「対象業務・環境・禁止事項・確認者・記録」で作る
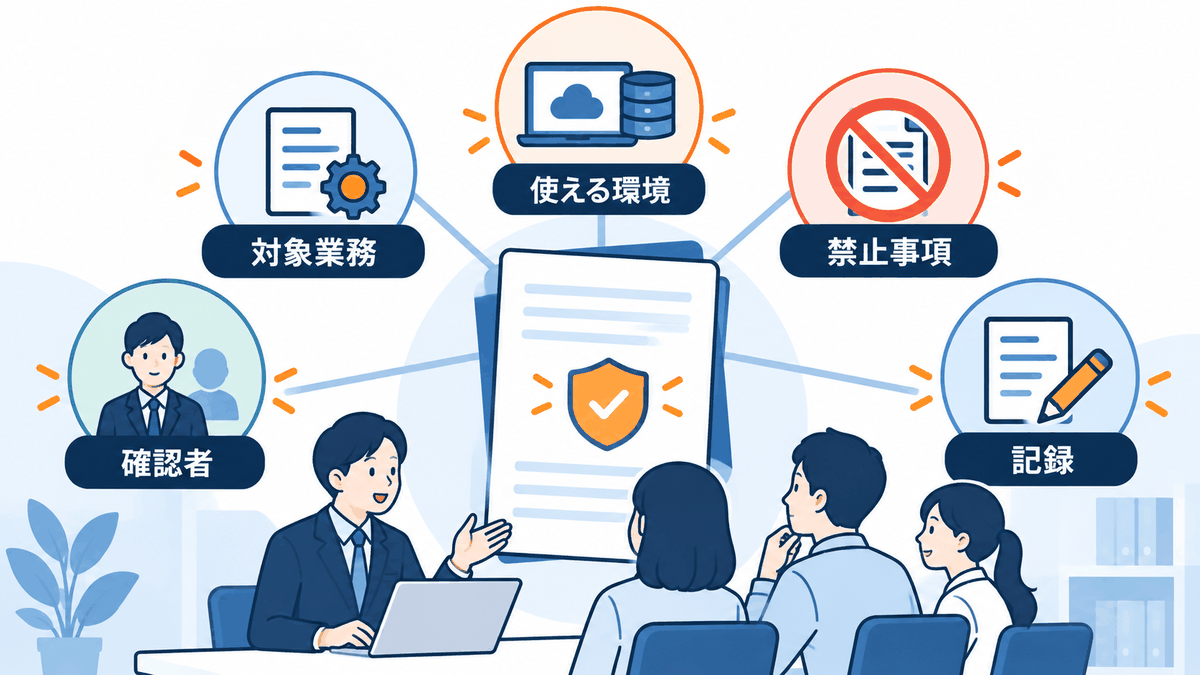
所内ルールを作ろうとすると、何十ページもの生成AIガイドラインを作ろうとして止まってしまうことがあります。
1〜5人程度の事務所で最初に必要なのは、立派な規程集ではありません。
所員が実際の仕事中に「これはAIに入れてよいか」「どこまでAIにやらせてよいか」を判断できるルールです。
そのため、最初は5項目に絞って作ると運用しやすくなります。
| 項目 | 所内で決める内容 | 記載イメージ |
|---|---|---|
| 対象業務 | AIを使ってよい仕事 | 公開資料整理、文書差分抽出、確認用下書きなど |
| 利用環境 | 承認する契約・アカウント | 事務所管理アカウントのみ、指定ワークスペースのみ |
| 禁止事項 | 入れてはいけない情報・使い方 | 未承認環境への未公開情報入力、禁止案件での利用など |
| 確認者 | AI出力を誰が確認するか | 担当者、有資格者、所長など |
| 記録 | 何を残すか | 使用した環境、重要なAI利用、承認結果など |
まず対象業務を決めます。
ここでは「生成AIを使ってよい」と広く書くのではなく、「公開公報の整理」「公開資料の比較」「文書差分の抽出」など、業務名で決めます。
次に利用環境を決めます。
「有料版なら可」ではなく、事務所が契約し、管理できるアカウントやワークスペースを指定します。所員が個人アカウントへ切り替えて利用することがないように、実際のログイン方法まで確認します。
禁止事項では、「未公開発明を入力禁止」と書くだけではなく、禁止対象となる環境も定義します。
同じ未公開情報でも、事務所が契約条件を確認した限定環境で特定業務に使う場合と、個人向けAIへ自由入力する場合を同じ扱いにする必要はありません。
ただし、どこまで利用可能とするかは、契約条件や案件条件に基づき事務所で決めます。
確認者についても、「必ず人が確認する」という曖昧な表現を避けます。
単純な形式チェックは事務職員、クライアントへ出す文書の内容は担当弁理士、運用ルールの例外判断は所長というように、確認者を業務ごとに決めます。
最後に記録です。
すべてのAI利用履歴を詳細に記録する仕組みは、小規模事務所では負担になる可能性があります。一方、未公開情報を扱う重要な利用について、どの環境を使い、誰が確認したのかが全く分からない状態も避けたいところです。
通常業務と重要なAI利用を分け、どこから記録を必要とするか決めると運用しやすくなります。
所員が迷わないルールは「禁止事項」より「判断経路」を決める
生成AIの所内ルールというと、禁止事項を並べることに意識が向きがちです。
しかし、実際の業務では、ルールに書かれていない状況が必ず出てきます。
たとえば、公開済みの技術と未公開の改良内容が一つの文書に混ざっている場合です。
「公開情報は利用可能、未公開情報は禁止」とだけ書いても、この文書をどう扱えばよいか職員は判断できません。
そこで重要になるのが、迷った場合の判断経路です。
| 状況 | 所員の対応 |
|---|---|
| 明確に公開情報だけ | 承認済みの業務・環境なら所内ルールに沿って利用 |
| 未公開情報を含む可能性がある | 入力前に止める |
| 公開・未公開が混在している | 必要部分を切り分けるか担当者へ確認 |
| クライアントのAI利用条件が不明 | 契約・案件条件を確認 |
| 新しいAIサービスを使いたい | 個人判断で導入せず事務所側で条件確認 |
| ルールにない使い方 | 所長・指定確認者へ事前確認 |
これなら、所員に法的判断を求める必要がありません。
「迷ったら禁止」というルールだけではAI活用が止まりやすくなりますが、「迷ったら誰に確認するか」まで決めれば、必要な案件だけ確認へ回せます。
クライアントへ生成AI利用を説明できる状態にする
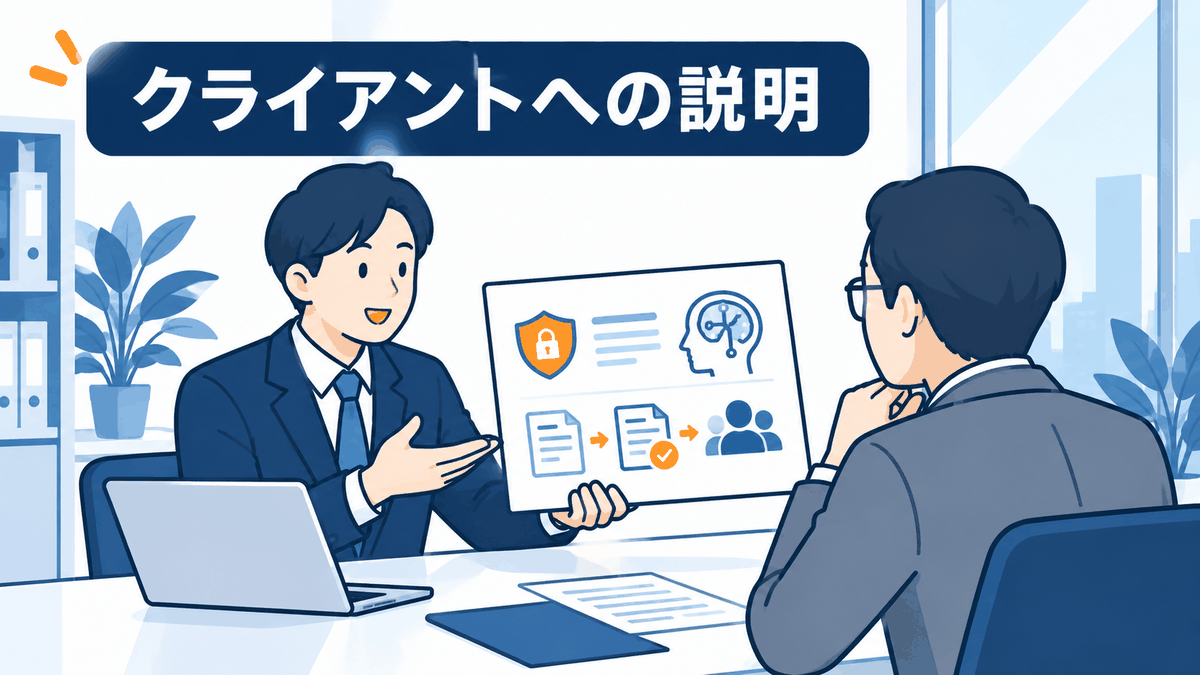
特許事務所で生成AIの所内ルールを作る目的は、内部管理だけではありません。
クライアントから「当事務所の情報をAIに入れていますか」「AIをどう使っていますか」と聞かれたときに、説明できる状態にすることも重要です。
「AIは使っていますが大丈夫です」という説明では不十分です。
反対に、「AIは一切使っていません」とすることで、本来安全に効率化できる公開情報の整理などまで止める必要があるかは、事務所として検討する余地があります。
クライアントへ説明するときは、AIのブランド名より、利用範囲を説明した方が伝わりやすくなります。
説明内容は、次のような構造にすると整理できます。
| 説明する項目 | 内容 |
|---|---|
| AIを使う範囲 | 下書き、情報整理、文書比較など |
| 人が担当する範囲 | 法的判断、最終確認、提出判断など |
| 情報管理 | 承認した環境のみを使用すること |
| 未公開情報 | 案件条件や契約条件を確認して扱うこと |
| クライアントの制限 | 個別の禁止・制限がある場合はそれを優先すること |
たとえば説明の考え方としては、「当事務所では生成AIを補助的な業務に利用する場合がありますが、利用環境を事務所で管理し、案件ごとの情報区分を確認したうえで使用しています。生成結果はそのまま確定情報として使用せず、必要な内容について担当弁理士が確認します」といった構造です。
ただし、これは契約条項そのものではありません。
委任契約書や秘密保持契約書へどのような表現を入れるべきか、特定の表現で法的に十分かといった点は、案件や契約内容によって異なります。
既存契約との整合を確認し、必要に応じて所属会や専門家へ確認してください。
委任契約や秘密保持契約との整合を先に確認する
生成AI導入後に契約を確認するのではなく、利用範囲を広げる前に契約との整合を見ておく方が安全です。
特に確認したいのは、秘密情報の第三者提供、再委託、外部クラウドの利用、データ保存場所、セキュリティ要件、生成AIや自動処理に関する個別条項です。
クライアントによっては、自社の情報管理基準を契約に組み込んでいることがあります。
また、同じクライアントでも、通常案件と研究開発の重要案件で条件が異なる可能性があります。
そこで、所内ルールを「事務所共通ルール」と「案件固有ルール」の二段構造にします。
事務所共通ルールでは、普段使えるAI環境、公開情報の扱い、標準的な承認フローを決めます。
案件固有ルールでは、「この案件では生成AIを使用しない」「この種類の情報は外部サービスへ送信しない」といった追加制限を設定します。
これにより、すべての案件を最も厳しい条件に合わせる必要がなくなります。
制度・手続・様式・期限に関する情報は一次情報でまとめて確認する
未公開発明と生成AIを考える際、新規性喪失の可能性を過度に単純化しないことが重要です。
日本の特許制度では、出願前に公開された発明は原則として特許を受けられない一方、一定の条件下で発明の新規性喪失の例外規定が設けられています。特許庁によると、権利者の行為に起因して公開された発明について例外規定の適用を求める場合、所定の要件のもと、公開から1年以内の出願や、出願時の手続、出願から30日以内の証明書類提出などが関係します。
ただし、この記事でいう「生成AIへ入力した」という行為が、個別案件で特許法上どのように評価されるかを一律には断定できません。
利用したサービスの契約、秘密保持条件、入力情報、アクセス可能性、具体的な公開状況などによって検討すべき事情が異なるためです。
また、新規性喪失の例外は、最初から自由に公開してよいことを意味する制度ではありません。
特許庁も、出願前に公開された発明は原則として特許を受けることができず、例外規定は一定条件のもとで設けられた制度として説明しています。
したがって、特許事務所の生成AIルールでは、「問題が起きても例外規定を使えばよい」といった運用にはしない方がよいでしょう。
制度、様式、手続、期限は改正される可能性があります。具体的な案件については、最新の特許庁資料、日本弁理士会の公表資料、関係法令を確認し、判断できない事項は所属会・管轄に確認してください。
生成AI側の条件も同様です。
日本弁理士会のガイドラインでは、生成AIの利用規約やプラン仕様は変更される可能性があるため、最新条件を把握することが重要とされています。
所内ルールを一度作って終わりにせず、少なくとも利用サービスの契約変更、新しいAI導入、クライアント条件の変更などをきっかけに見直す必要があります。
ルールを決めた後は低リスクの業務から生成AIを組み込む
所内ルールができたら、いきなり未公開発明を扱う中心業務へ生成AIを入れる必要はありません。
まずは公開情報を中心とした業務から始める方が、事務所としてAIの特性を理解しやすくなります。
たとえば公開公報を同じ形式で整理する、公開資料同士を比較する、公開済み情報から社内確認用の文章を作るといった仕事です。
この段階で確認したいのは、AIがどの程度間違えるかです。
同じ指示でも重要な項目を落とすのか、数字を取り違えるのか、資料に書かれていない内容を補ってしまうのか、長い資料で抜けが出るのかを確認します。
ここで得られる知識は、所内ルールを改善する材料になります。
たとえば「公報比較では、必ず公報番号と該当箇所を併記させる」「数値を抽出した場合は元ページを示させる」「資料にない情報は推測せず『記載なし』と表示させる」といった確認方法を標準化できます。
AI導入は、一度設定したら完成するシステムではありません。
使いながら「どこで間違えるか」「どこまでなら確認しやすいか」を把握し、AIへ任せる範囲を調整していくものです。
未公開情報を扱う仕事へ広げるのは、利用環境、案件条件、人による確認方法が固まってからでも遅くありません。
「AIに何をさせるか」より先に「人が何を確認するか」を決める
生成AIの導入相談では、「何が自動化できますか」という質問から始まりやすくなります。
しかし、士業では反対から考えた方が業務を設計しやすくなります。
つまり、最後に人が何を確認しなければならないかを決め、そこから逆算してAIへ任せる工程を決める方法です。
たとえば最終的に弁理士が3つの公開公報を比較し、ある論点について判断するとします。
その場合、AIに任せるのは判断そのものではなく、それぞれの公報から比較に必要な記載を抜き出し、同じ形式に並べる作業です。
人が原文を確認できるよう、出典も残します。
最終確認に必要な情報がそろうところまでAIが準備し、その先を人が担当します。
この方法なら、AIが高度になっても役割分担が崩れません。
新しいAIが登場するたびに「これは使ってよいのか」とゼロから考えるのではなく、「このAIを、現在の業務フローのどの工程に置けるか」と判断できます。
士業のAI導入で共通して詰まりやすい3か所
未公開発明は特許事務所固有の重要論点ですが、AI導入が実務で止まりやすい場所には、士業をまたいだ共通点があります。
土地家屋調査士事務所、中小企業診断士事務所、税理士事務所などでも、仕事の専門領域は違っていても、AI化が難しい場所は似ています。
一つ目は、AIが仕事を始める前です。
書類がばらばらで、案件名も形式も統一されていなければ、AIへ渡す前に人が整理しなければなりません。
二つ目は、正しさを確認する場面です。
士業の仕事には、Aという文書だけを見ても正解が分からず、BやCの文書と見比べなければ判断できない仕事が多くあります。
三つ目は、複数のシステムをまたぐ場面です。
メール、PDF、Excel、案件管理、専門ソフトなどを同時に開き、人が情報を転記・統合しています。
この3か所を整理すると、AIへ任せやすい部分が見えてきます。
| 詰まりやすい場所 | 人が担当すること | AIへ任せやすいこと |
|---|---|---|
| AIへ渡す前 | 必要情報の選定、機密性の判断、案件条件の確認 | 文書整理、形式統一の補助 |
| 複数文書の確認 | 正しさの判断、重要差分の評価 | 差分抽出、共通項整理、照合候補抽出 |
| 複数システムへの反映 | 承認、確定、最終登録 | 転記用データの抽出・整形 |
ここから分かるのは、士業のAI導入では「人をAIに置き換える」より、人が判断する直前までの準備作業をAIへ寄せる方が始めやすいということです。
特許事務所であれば、未公開発明に関する判断や責任を弁理士からAIへ移す必要はありません。
弁理士が判断するために必要な資料整理や比較作業を短くすることでも、十分に業務改善につながります。
少人数の特許事務所では「所長だけが知っているルール」にしない
1〜5人程度の事務所では、所長と職員の距離が近いため、ルールを文書化しなくても運営できているように感じることがあります。
生成AIについても、「重要な情報は入れないで」「変な使い方はしないで」と口頭で伝えているだけのケースがあります。
しかし、生成AIでは「重要な情報」の意味が人によって変わります。
所長は出願前の技術情報を想定していても、職員は会社名だけ消せばよいと理解しているかもしれません。
また、職員が「ChatGPTへ直接入れるのはだめだが、別の文章作成AIならよい」と誤解する可能性もあります。
サービス名を禁止するだけでは、別サービスへ移るだけです。
だからこそ、ルールでは理由まで共有する必要があります。
「ChatGPT禁止」ではなく、「承認されていない外部AI環境へ未公開情報を入力しない」とすれば、新しいAIサービスが出ても判断基準が変わりません。
「AIの回答を信用しない」ではなく、「AIが抽出した内容は元資料との一致を確認してから確定する」とすれば、職員が具体的に行動できます。
良い所内ルールとは、注意書きが多いルールではありません。
所員が仕事中に次の行動を決められるルールです。
個人契約の生成AI利用を放置しない
小規模事務所では、法人向けAIを導入する前から、所員が個人的に生成AIを使っている可能性があります。
この状態で法人向け環境だけ契約しても問題は解決しません。
最初に確認すべきなのは、「何を契約するか」より「現在どのAIが使われているか」です。
職員を責める目的ではなく、実態を把握します。
文章の校正だけに使っているのか、クライアントから届いたメールを貼り付けているのか、PDFをアップロードしているのか、個人アカウントと業務アカウントを使い分けているのかによって、対応が変わります。
特に「個人向けAIの学習利用をオフにしているから問題ない」と考えている場合は、学習設定だけでなく、事務所としてアカウントを管理できるか、データ保持条件はどうなっているか、クライアントとの契約上問題がないかを改めて確認します。
OpenAIでも、個人用ワークスペースと法人向けサービスではデータ利用の初期設定が異なります。
生成AIは日々のブラウザやスマートフォンから簡単に使えるため、「導入申請をしなければ使えない業務システム」とは性質が違います。
禁止するだけでは、見えないところで利用が続く可能性があります。
承認環境を用意し、「この業務ならここまで使える」という選択肢を提示することも、管理の一部です。
所内ルールは半年後にも使える書き方にする
生成AIサービスは変化が速く、プラン名、機能、設定方法、データ処理条件などが更新される可能性があります。
そのため、所内ルールへ細かい画面操作を大量に書き込むと、すぐに古くなります。
日本弁理士会も、利用規約やプラン仕様は変更される可能性があり、最新条件を把握することが重要としています。
ルール本文では、「事務所が承認した法人向けワークスペースを使用する」「未承認の外部AIへ案件情報を入力しない」といった原則を書きます。
具体的なサービス名、プラン名、設定状態は別表として管理すると更新しやすくなります。
| 管理するもの | 更新方法 |
|---|---|
| 所内ルール本文 | 業務方針や判断基準が変わったときに更新 |
| 承認AI一覧 | 契約追加・変更・終了時に更新 |
| 設定確認表 | サービス仕様変更時に更新 |
| 案件別制限 | クライアント条件に応じて更新 |
| 確認フロー | 担当者や業務分担変更時に更新 |
こうしておけば、新しいAIを追加するときも、所内ルール全体を作り直す必要がありません。
新しいサービスが現在の承認条件を満たすか確認し、承認AI一覧へ追加します。
ルール作成だけで終わらせず実際の業務フローへ落とし込む
AI所内ルールを作っても、業務が以前と変わらなければ生産性は上がりません。
ルールは「事故を防ぐ仕組み」であり、AI導入のゴールではありません。
次に必要なのは、実際の業務を一つ選び、現在の流れを書き出すことです。
たとえば公開公報の比較であれば、「資料を集める→ファイル名を確認する→必要箇所を読む→Excelへ転記する→比較する→担当弁理士が確認する」という現在の仕事を分解します。
その中から、「資料から必要項目を抜く」「同じ形式に並べる」「差分候補を出す」といった工程をAIへ渡します。
最終判断の工程は残します。
この方法であれば、生成AI導入の効果を「便利になった」という感想ではなく、どの工程が短くなったかで確認できます。
少人数事務所では、大規模なシステム開発をしなくても、定型プロンプト、共有フォルダ、表計算、案件管理などを組み合わせるだけで改善できる業務もあります。
重要なのは、AI単体で考えないことです。
AIへ渡す前の入力、AIが処理する部分、AIの出力先、人の確認までを一本の仕事として設計します。
補助金を検討する場合も、先にAIを使う業務を決める
士業事務所が生成AIや業務効率化ツールの導入を検討する際、デジタル化・AI導入補助金などの活用を考えることもあります。
ただし、補助金ありきでツールを選ぶより、「どの業務を改善するのか」「AIへ何を任せるのか」「どの情報を扱うのか」を先に決めた方が、導入後の運用を設計しやすくなります。
士業向けのデジタル化・AI導入補助金については、制度の対象や確認事項を別記事で整理しています。
本記事で扱っている情報管理と所内ルールは、補助金を利用するかどうかにかかわらず必要です。
よくある質問
特許事務所では未公開の発明を生成AIへ一切入れてはいけませんか?
「すべての生成AI環境で一律に禁止」「特定の法人向けプランなら一律に可能」と単純化することはできません。
日本弁理士会は、秘密情報を外部事業者の生成AIへ入力することについて守秘義務等との関係に注意を求めるとともに、新規性喪失の観点から、秘密保持規約等のあるプラットフォームか確認する必要があるとしています。
利用環境、AI提供者との契約、クライアントとの契約、入力情報、利用目的を確認して事務所内のルールを決めてください。個別案件の法的評価について判断できない場合は、所属会・管轄に確認してください。
法人向けの生成AIなら未公開情報を自由に入力できますか?
法人向けであることだけでは判断できません。
モデル学習への利用、保存期間、管理権限、契約条件、外部連携などを確認する必要があります。また、AI提供会社側の条件を満たしていても、クライアントとの契約で利用が制限されていれば、その条件を確認する必要があります。
「法人向け=何でも入力可」ではなく、「承認環境の候補になる」と考える方が安全です。
学習をオフにすれば個人向けの生成AIへ案件情報を入れてよいですか?
学習利用をオフにすることと、業務情報を入力してよいかどうかは別の問題です。
学習に使われなくても、データ保持、アカウント管理、契約条件、外部連携などの論点があります。
特に事務所として管理できない個人アカウントを業務利用する場合は、誰がどの設定で利用しているのか把握しにくくなります。
所員個人の判断に任せるのではなく、事務所として承認環境を決めることをおすすめします。
生成AIが作った明細書の文章はそのまま使えますか?
生成AIの出力をそのまま確定内容として扱うのは避けるべきです。
日本弁理士会は、生成AIから得られた生成物は正確性が保証されず、弁理士が正確性を確認し、最終的には弁理士が責任を持って提供すべきとしています。
AIを下書き補助として使う場合でも、元情報との一致、技術内容、表現、法的判断に関わる部分などを担当弁理士が確認する業務フローを作ります。
所内ルールはどの程度細かく作ればよいですか?
少人数事務所であれば、最初から長大な規程を作る必要はありません。
「何の業務で使えるか」「どの環境を使うか」「何を入力してはいけないか」「誰が確認するか」「何を記録するか」が明確なら、実務上の判断を始められます。
運用中に迷った場面を記録し、必要なルールだけ追加していく方が定着しやすくなります。
まとめ
特許事務所が生成AIを導入するとき、最も重要なのは「生成AIを使うか、禁止するか」を決めることではありません。
決めるべきなのは、どの契約・設定の環境に、どの段階の情報まで入れるのかです。
公開済み公報の整理と出願前の発明情報を同じ扱いにする必要はありません。また、個人向けAIと事務所が管理する法人向け環境を同じ扱いにする必要もありません。
利用環境と情報段階を二軸で分けることで、全面禁止と自由利用の間に、実務で使える境界を作れます。
そのうえで、仕事を「トリガー」「AIへ渡す情報」「反映先」「人が確認する箇所」「注意点」まで分解します。
AIへ任せやすいのは、下書き、複数文書の突合、転記前の情報整理などです。
一方、発明内容の理解、法的判断、クライアントへ提示する内容、提出前の最終確認など、専門職として判断と責任を伴う部分は有資格者が担います。
つまり、目指すべき状態は「AIが弁理士の代わりに判断すること」ではありません。
判断と責任は有資格者、下書き・突合・転記はAIという役割分担を作り、有資格者が本来確認すべき仕事へ時間を使える状態にすることです。
また、所内ルールは所長だけが理解していても機能しません。「未公開情報は気を付ける」といった曖昧な注意ではなく、承認環境、情報区分、確認者、迷ったときの判断経路を文書にしておく必要があります。
生成AIサービスの規約やプラン仕様は変わる可能性があります。日本弁理士会も最新条件の確認を求めているため、利用サービスや設定を定期的に確認し、事務所のルールも更新していきましょう。
生成AIを安全に使うには、ツールを導入するだけでなく、入力する情報、AIへ任せる作業、人が確認する箇所まで業務フローとして決める必要があります。少人数の士業事務所でも、現在の仕事の流れから整理できます。
AIは導入して終わりではありません。業務のどこをAIへ渡し、どこを人に残すかの整理から、定着までを伴走します。